GeoGebra 能精确测量一张"搭错了的图":Draw2Think 论文精读
有一道题要求:过点 A 作 AB 的垂线,交圆 O 于点 C。
模型选错了点,它让 GeoGebra 做了另一件事:过点 D 作 AB 的垂线,与圆 O 求交。
GeoGebra 完整执行成功,之后测出的角度、长度全部精确。
那么这一次,算成功还是失败?
这篇文章要讲的论文,价值不在"让模型更会做几何题",而在于它把上面这个问题逼到了必须回答的地步。
论文信息
| 项目 | 内容 |
|---|---|
| 标题 | Draw2Think: Harnessing Geometry Reasoning through Constraint Engine Interaction |
| 作者 | Juncheng Hu、Jiawei Du、Xin Zhang、Joey Tianyi Zhou |
| 机构 | National University of Singapore;A*STAR CFAR / IHPC |
| 版本 | Preprint,arXiv:2605.20743v1 |
| 路线 | 冻结 VLM + GeoGebra 约束引擎,不做任务微调 |
01 这篇论文一句话讲什么
让一个冻结的 VLM,通过带类型的工具调用,反复构造、查询、修订一个 GeoGebra 画布;再对最终构造出的图做一次独立的谓词审计。
它的贡献更像是一个被设计过的工具运行框架,而不是一个新模型。
这句话里有个容易被忽略的词:冻结。论文不训练模型、不加新权重,全部收益来自"推理时给模型配一个可执行的几何工作区"。
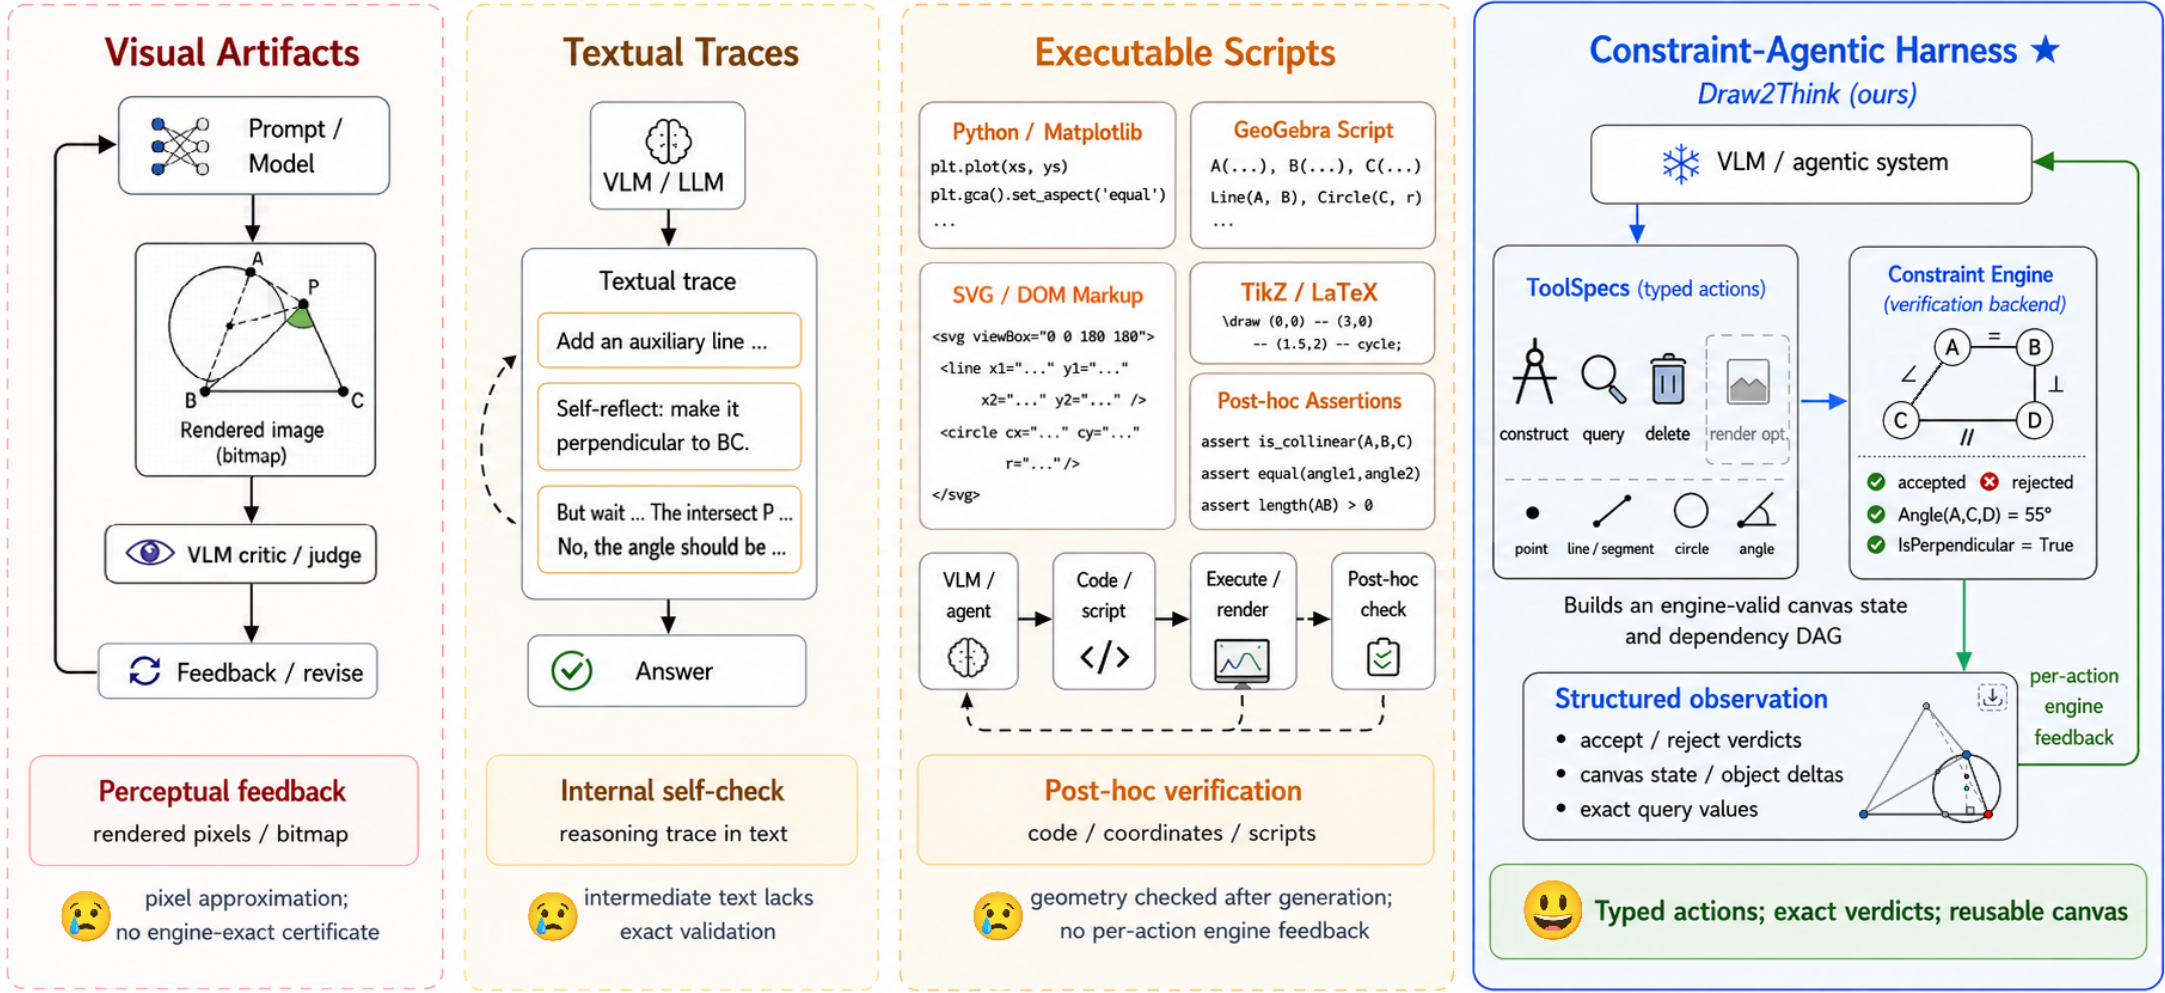
四种外化中间状态的路线对比。Draw2Think 的差别在最后一种:验证在每一步动作之后立刻发生,而不是等最后执行一次。
02 它真正想解决的问题
论文的出发点不是"模型算错了",而是一句更精确的描述:
视觉语言模型在推理时会把角度、辅助线、长度关系当作后续前提,但这些中间状态可能只存在于文字或潜在表征中,从未被任何执行环境检查过。
注意关键词:潜在(latent)。
意思是,模型内部"以为"自己构造了一个垂直关系,但这个关系没有落到任何可检查的载体上。它可能对,可能错,而我们没有任何手段区分。
论文举了一个真实案例(MathVista/290):基线模型错把两个角当成相等,用内错角推完,输出 105°;走构造+测量的闭环之后,读出来是 75°。
一次局部误读,会顺着推理链一路传播下去。这就是论文想切的口子。
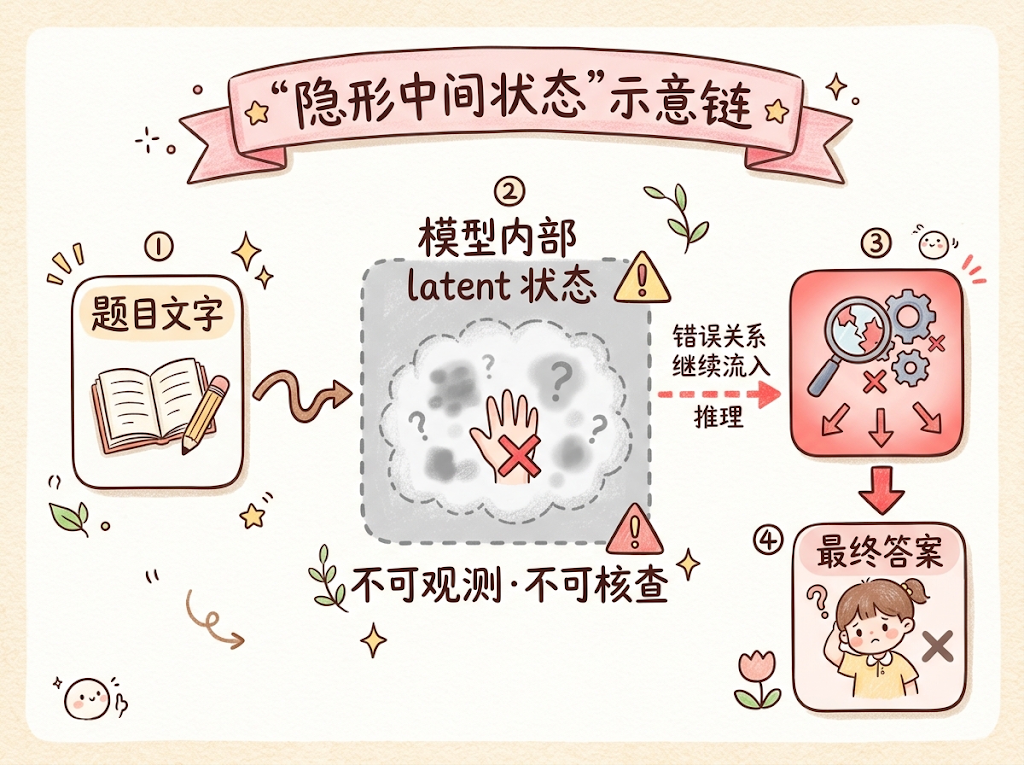
论文真正针对的不是"模型不会做",而是中间状态没有任何外部凭证。
03 以前的方法为什么不够
论文在 Related Work 里把路线分成几类,并给出了自己的定位。这里必须加一句提醒:这个对比是作者框定的,不能直接读成"旧方法都不能做精确检查"。
| 路线 | 中间表示与反馈 | 论文认为的缺口 |
|---|---|---|
| 文字 / 图像 CoT | 文本推导、生成图像、视觉再观察 | 缺约束级凭证,视觉近似不等于数学关系成立 |
| 绘图程序与渲染反馈 | 代码、可修改图形状态 | 检查发生的时机与返回值权威性不足 |
| 符号求解与形式推理 | 公理、谓词、推导 | 处理证明义务,但与"边构造边读数的实例求解"侧重点不同 |
| Draw2Think | typed ToolSpecs → 持续画布 → 对象变化 / 数值 / 错误 | 把执行、读数、局部恢复接进推理循环 |
论文对"像素相似"和"几何正确"的区分,是这条对比的基础:一张图看起来接近 90°,不代表它满足垂直约束。 视觉上几乎垂直的线,实际可能是 89°。
这里有一个很值得记住的说法:约束优先(constraint-first)。
- 方法 1:先生成一个视觉结果,然后希望它满足几何关系;
- 方法 2:先声明"我要一个满足垂直关系的对象",再由引擎生成满足该关系的结果。
这不是"方法 2 更准"的问题,而是承诺顺序反过来了。
04 核心方法:Propose–Draw–Verify
论文把整个几何求解写成了一个状态空间搜索,而不是"调用几个工具"。
符号都不复杂,逐个说:
- :当前画布状态(已经构造了哪些对象、满足哪些关系);
- :这一步的动作;
- :引擎执行这个动作;
- :执行之后的新画布;
- :从最终状态 里把题目要的答案读出来。
它强调的其实是:第 2 步能做什么,取决于第 1 步已经在画布上建立了什么。 所以被"搜索"的不是一句答案,而是一个能支持正确读数的几何世界状态。
一个具体例子,从空画布开始:
S0 = 空
 → S1 = {A, B}
 → S2 = {A, B, 线段 AB}
 → S3 = {A, B, AB, 过 A 的垂线}
 → 求交点、读角度、给答案
三个角色的分工是这样的:
Propose:VLM 决定下一步做什么(选工具 u_k + 填参数 φ_k)
   ↓
Draw:GeoGebra 执行动作,更新画布(S_k = T(S_{k-1}, a_k))
   ↓
Verify:引擎把对象变化、数值或错误返回给模型
论文把 拆开,并写成这个分解:
为什么这个拆分有用? 因为它说明"知道该作垂线"和"把点对象误传成线参数"是两种不同的失败。选工具和填参数是两个难点,前者更依赖自然语言描述,后者更依赖类型签名和前置条件。
论文还给了两组工程细节,都跟"实战能不能跑起来"有关:
- 工具目录:平面共 92 项 = 55 构造 + 24 查询 + 13 渲染;普通平面解题实际暴露 79 项,13 个渲染工具只用于 GenExam,3D 另外激活 21 个扩展;
- 持久状态:对象依赖构成 DAG,删除父对象时级联删除后代。某一步失败时,动作被拒绝,但之前成功的对象保留下来,模型只需修改当前分支。
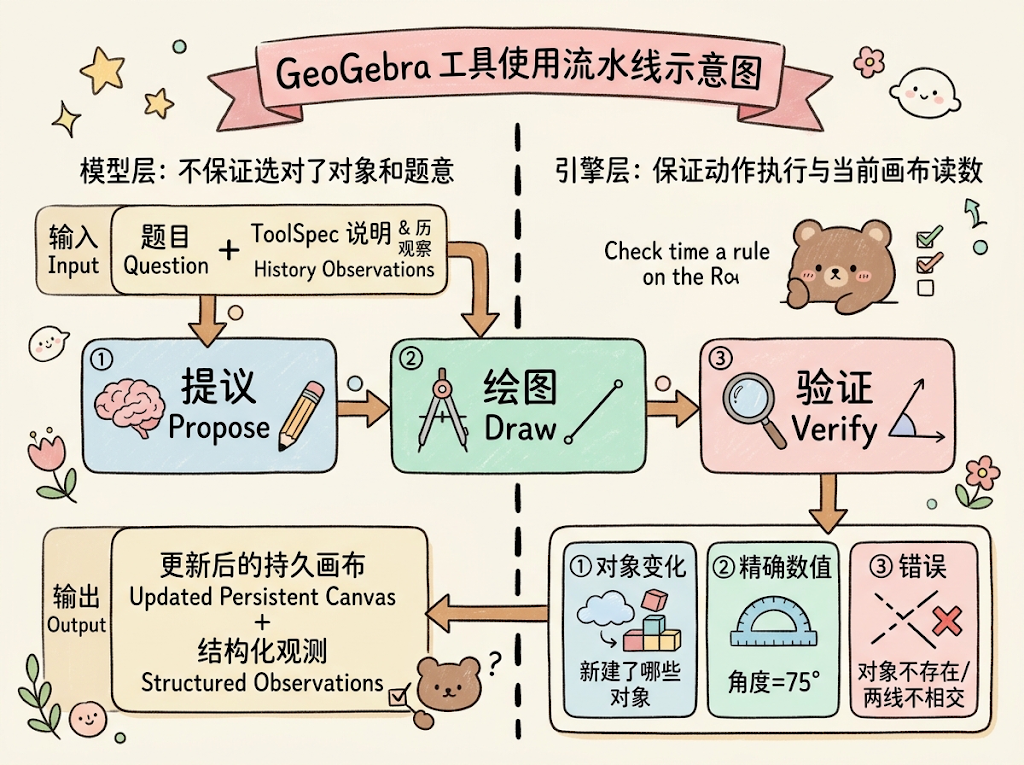
PDV 数据流。中间那条线是全文最重要的一条线:引擎不会跨过去替模型判断题意。
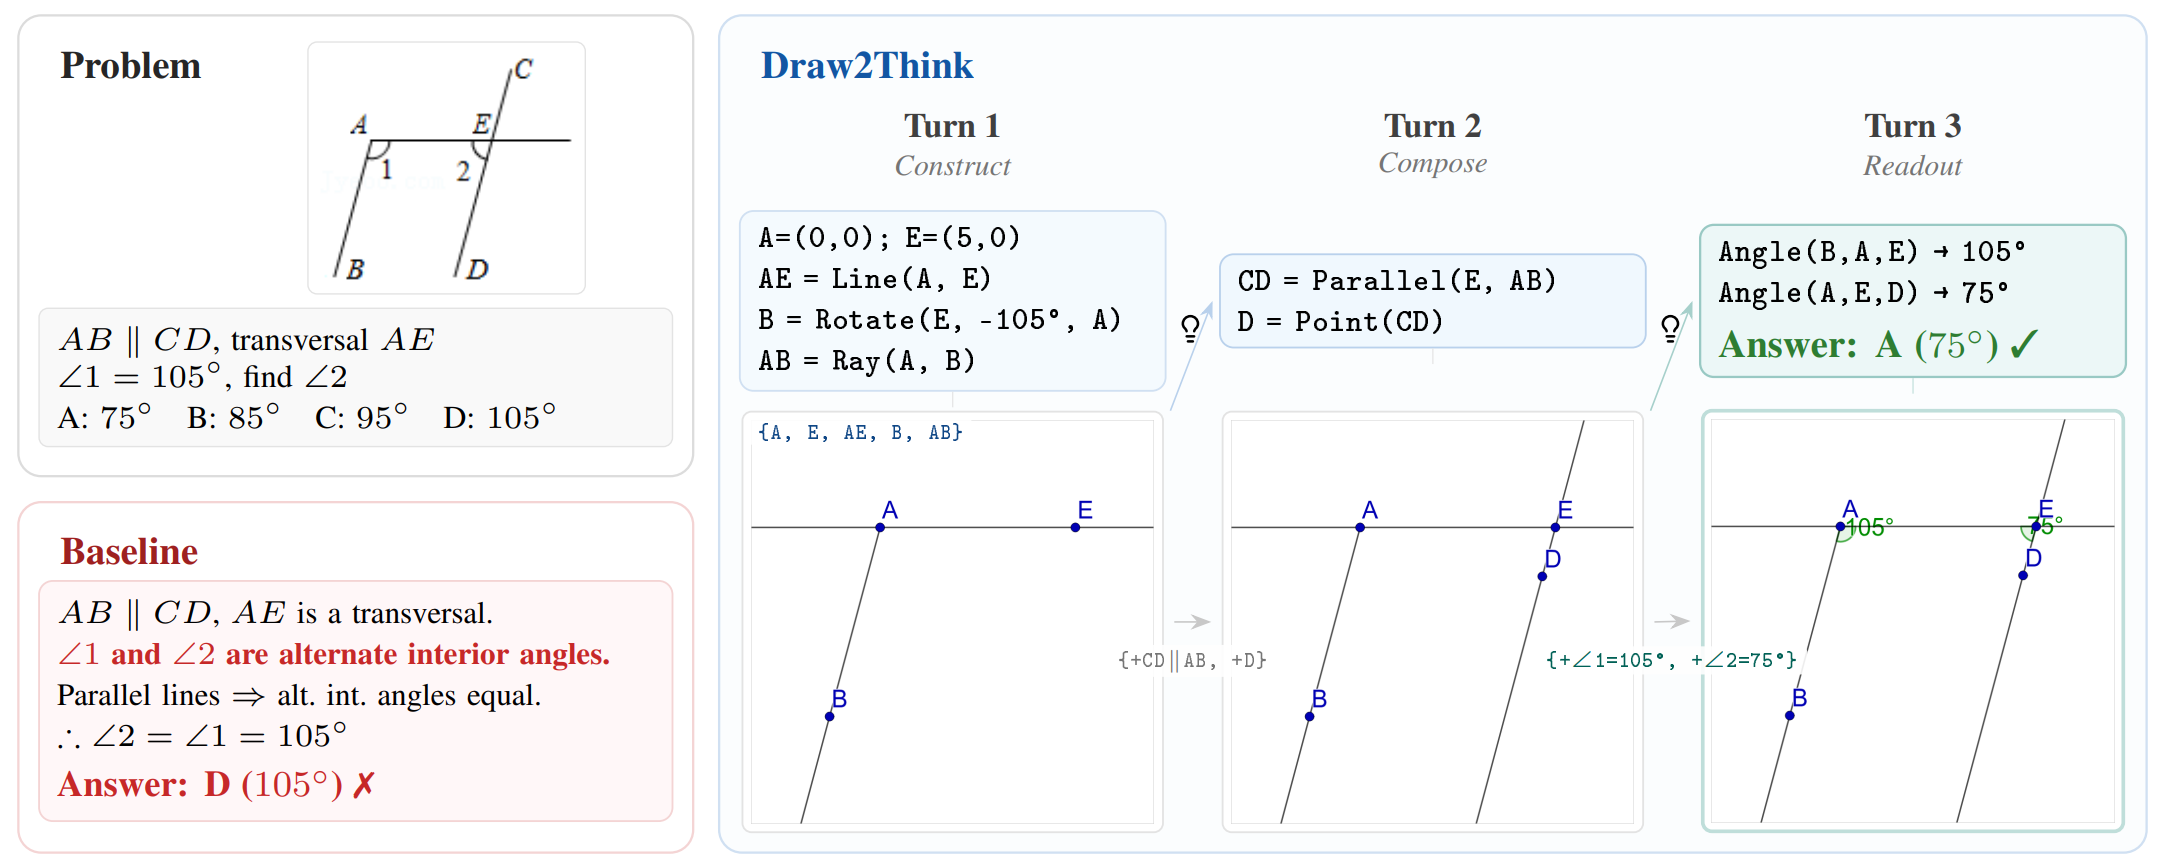
同一个模型,两种推理模式。差别不在模型,而在中间状态有没有被引擎检查。
05 全文最重要的边界:两种"忠实"
这是这篇论文最容易被误读、也最值得带走的一点。论文特意把两个概念拆开:
| 概念 | 归属 | 回答的问题 | 谁保证 |
|---|---|---|---|
| Construction Fidelity(构造忠实度) | 模型层属性 | 最终画布是否满足题目要求的几何关系? | 不由引擎保证,需要离线审计 |
| Measurement Faithfulness(测量忠实度) | 引擎层属性 | 在当前这个画布上返回的数值/关系是否忠实? | 引擎自动保证 |
回到开头的例子:
- Measurement Faithfulness ✅ 成功。因为 GeoGebra 忠实回答了"这张(错误的)图里,角度是多少、长度是多少";
- Construction Fidelity ❌ 失败。因为题目要求的是
Perpendicular(A,B,C),模型实际构造的是Perpendicular(D,B,C)——对象关系对不上。
关键结论只有一句话:引擎可以非常准确地测量一张搭错了的图。
论文自己的说法是:引擎保证的是"当前画布能推出什么",而不是"当前画布是否符合题目意图"。
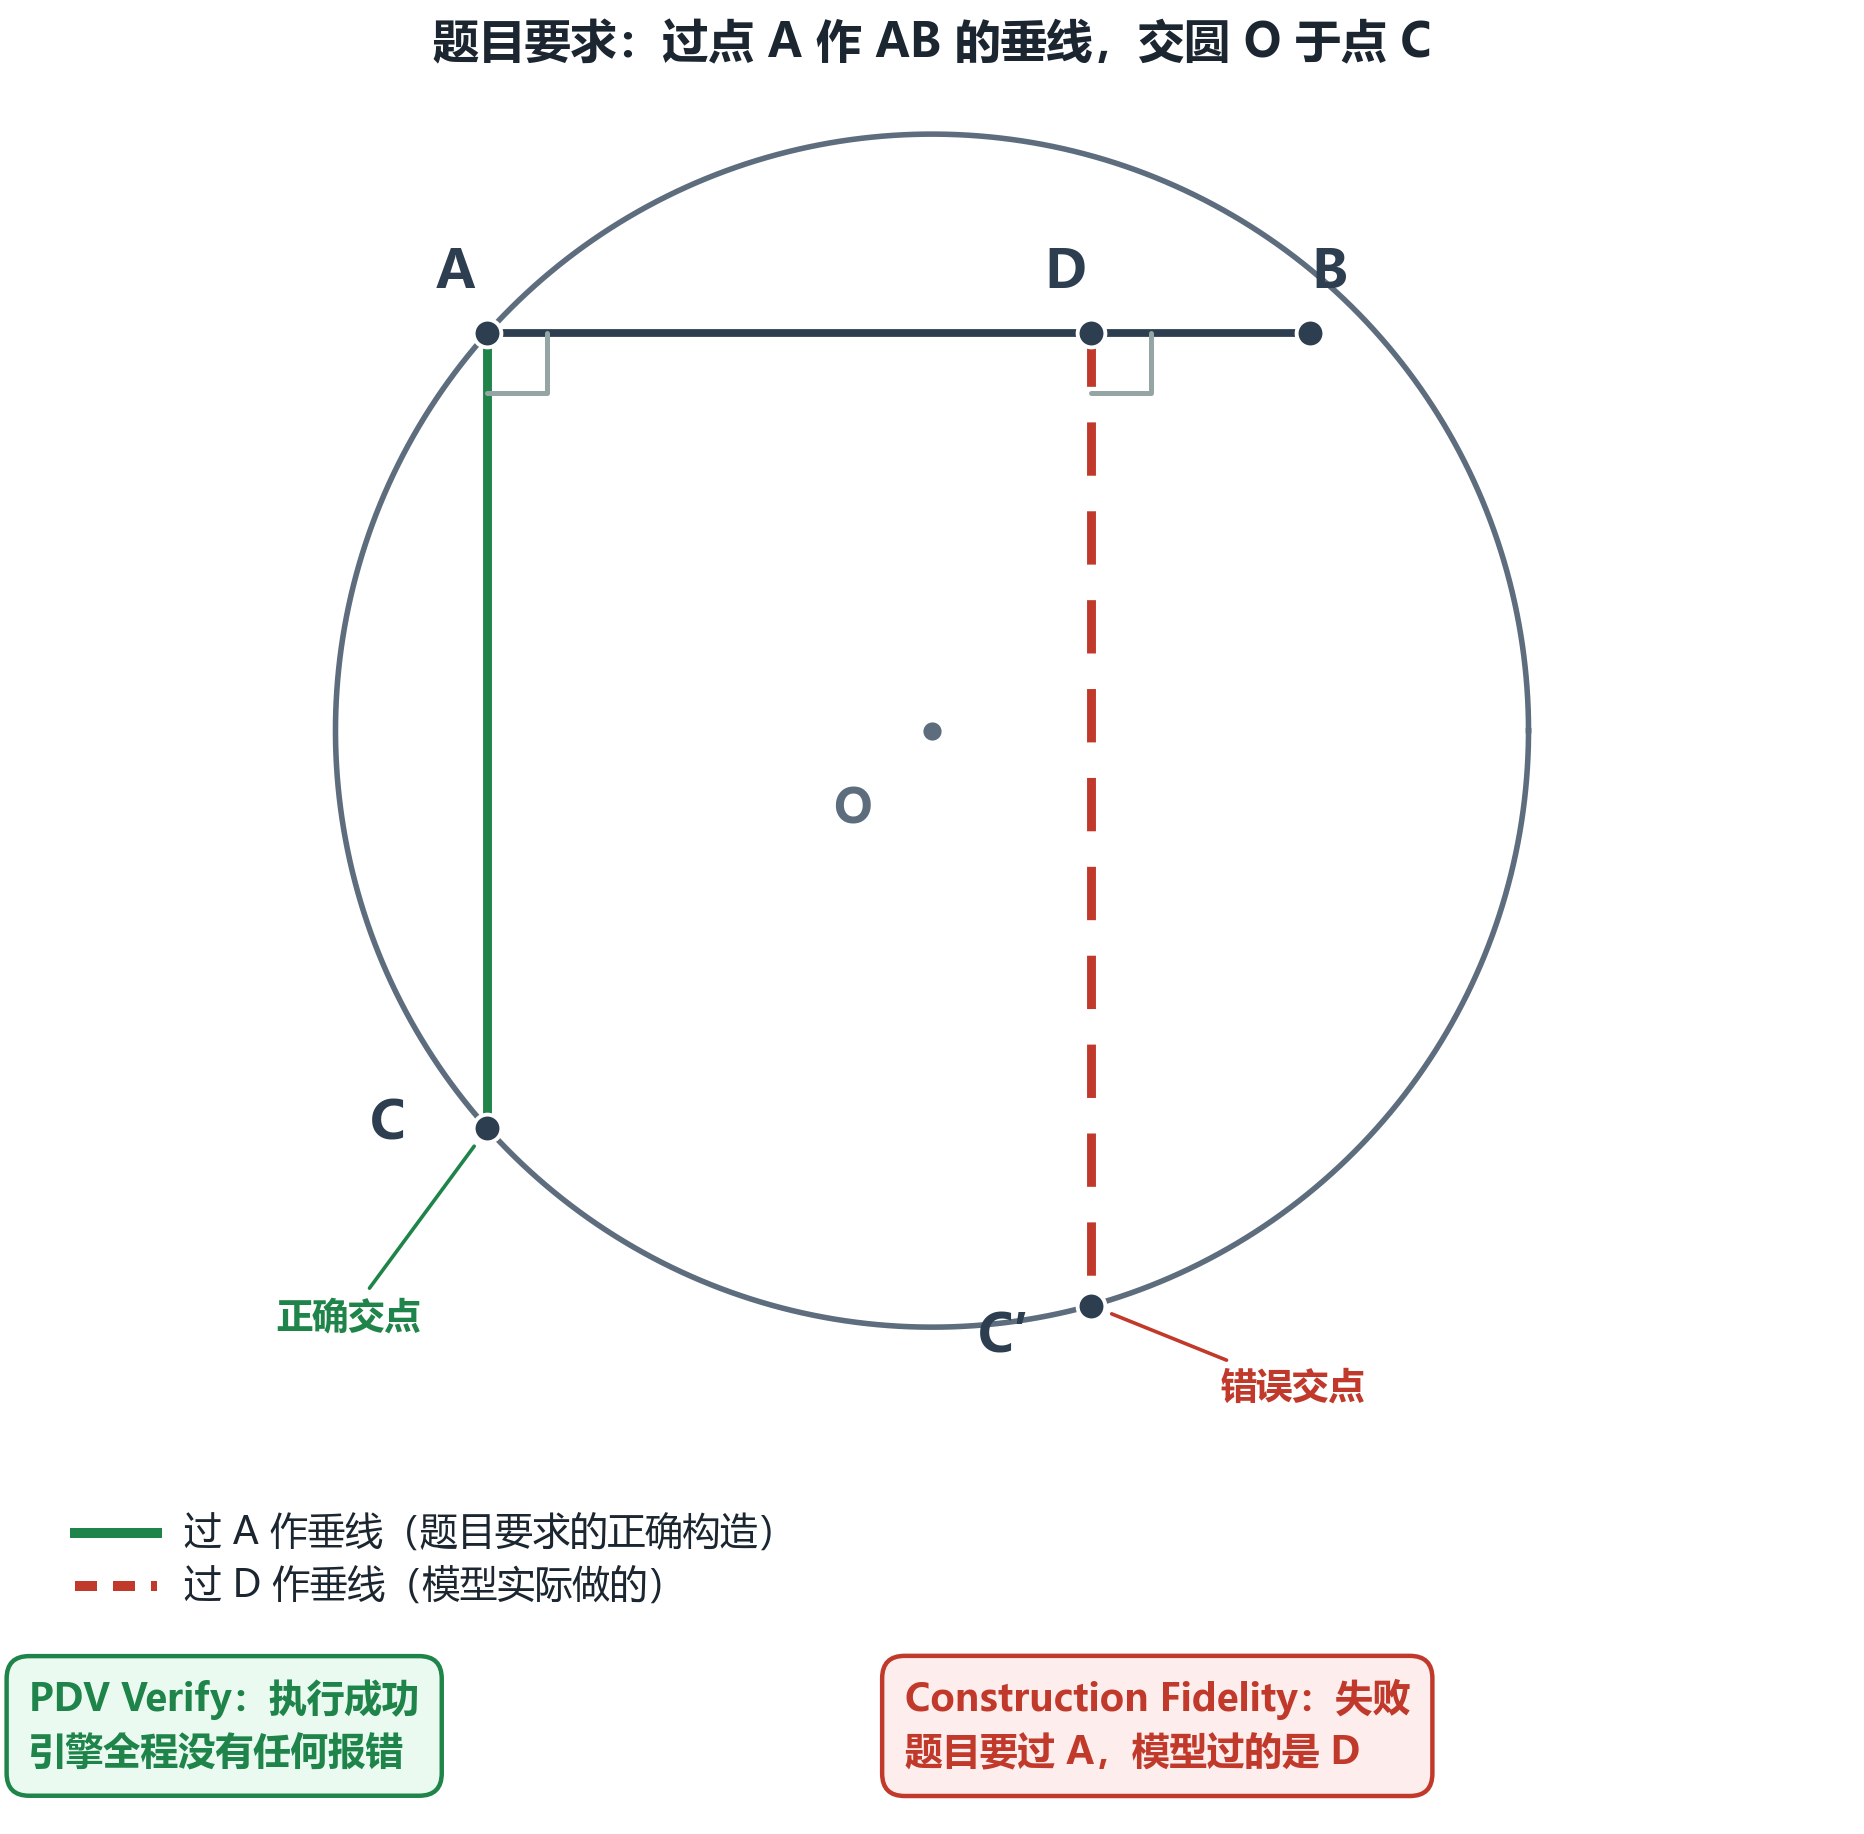
同一张合法画布,两种判定。GeoGebra 全程没有报错,因为它根本不知道你选错了点。
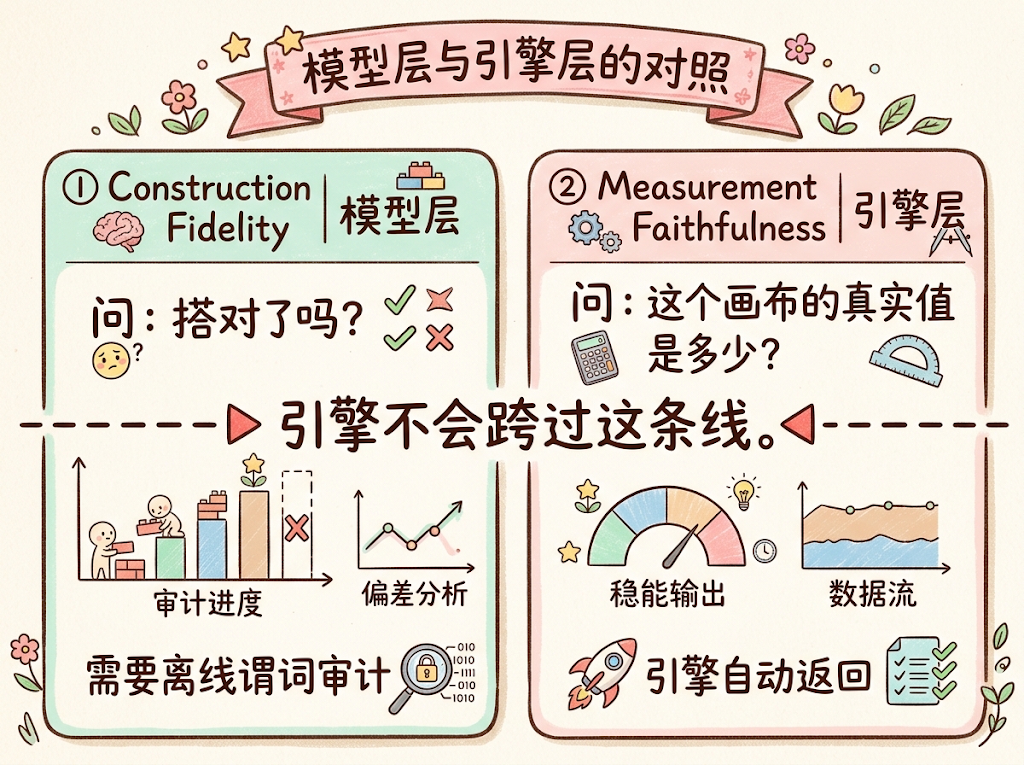
记住这张图,就能避免 90% 对几何 Agent 的过度解读。
06 那么 PDV 里的 Verify 到底验证了什么
承接上一节,必须把 PDV 的 Verify 和"验证题意"切开:
Verify:
"你让我做的这个动作,我有没有正确执行?"

Construction Fidelity:
"你让我做的这个动作,本来是不是题目真正需要的?"
PDV 的 Verify 能告诉你:
- 这个动作是否合法;
- 创建了什么对象;
- 当前测量值是多少;
- 有没有执行错误。
它不能自动判断:
- "你是不是选错了点?"
- "这条辅助线是不是题目真正需要的?"
- "整个画布是否已经完整符合题意?"
这也是为什么论文要把 Construction Fidelity 单独拿出来做离线审计,而不是宣称 PDV 已经解决了题意正确性。
论文在这里还做了另一件事:把错误拆成两类,因为它们需要不同的修法。
| 错误类型 | 含义 | 容差放宽后 |
|---|---|---|
| Structural error(结构错误) | 几何关系本身就错了,比如该垂直却构造成平行 | 不改善,形成基本不动的平台 |
| Numerical / precision error(数值错误) | 关系对,但坐标/浮点精度没过阈值 | 通过率会上升 |
小测试:某个角理论上是 90°,构图关系正确,但引擎读出来是 89.9998°——这属于哪一类?
答案是第二类。这类区分直接决定了你该改模型策略,还是该改数值处理。
07 实验结果:不是全面提升,而是"选择性收益"
论文主实验用 Gemini-3-Flash Preview,temperature=0,Pass@1,同题同模型;BL 是直接作答(单次调用),CT 是闭环构造(最多 30 轮,每轮 120 秒)。
结果是这样一组数字(单位 %,差值为百分点):
| 数据集 / 设置 | N | BL | CT | 差值 |
|---|---|---|---|---|
| SolidGeo-hard Level 3 | 177 | 59.9 | 76.3 | +16.4 |
| MathVerse-solid | 119 | 82.4 | 88.2 | +5.8 |
| GeoSketch | 390 | 81.8 | 85.9 | +4.1 |
| MathVerse Plane | 510 | 87.5 | 91.0 | +3.5 |
| GeoQA / UniGeo calc test | 754 | 93.6 | 96.9 | +3.3 |
| GeoLaux | 221 | 93.2 | 94.1 | +0.9 |
| MathVista GPS | 208 | 97.1 | 97.6 | +0.5 |
| OlympiadBench | 112 | 89.3 | 89.3 | 0.0 |
| Geo3K | 601 | 98.2 | 95.3 | −2.9 |
| PGPS9K | 1,000 | 94.5 | 90.5 | −4.0 |
有涨有跌,这才是这篇论文最有意思的地方。 作者管这叫 selective gains(选择性收益),并给了机制解释:
- 涨得多的,是视觉依赖强、需要空间构造的题(困难 3D、几何草图)。此时引擎替代的是昂贵又不稳定的内部空间模拟;
- 跌的,是本来就接近饱和的教材类基准。此时基线用便宜的内部推理就能做对,强制走一遍构造—查询流程只是额外增加了决策点和失败机会。
论文里有一句可以直接抄进笔记的结论:External tools are not universally beneficial.
换成工程语言就是:工具不是越多越好,而是当瓶颈真的存在时才有价值。
一个应用判断:三角形两角 50° 和 60° 求第三角,这题需要的是一次 180−50−60 的心算,而不是建一个画布。
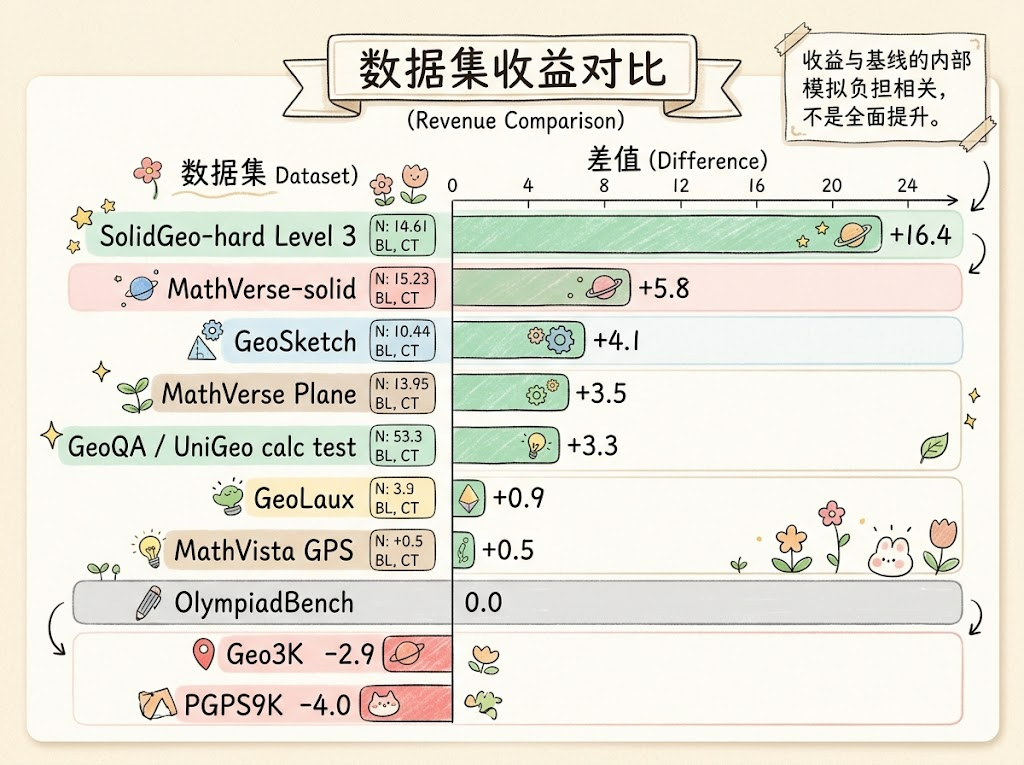
同样一套系统,在困难 3D 上 +16.4,在 PGPS9K 上 −4.0。工具的价值高度依赖题型。
08 GeoGoal:95.94% vs 84%,还有一个 100% 的陷阱
为了独立审计"模型到底搭对了没有",论文用了 GeoGoal:256 道题、13,254 个几何谓词、7,395 个查询表达式。评估器只看最终画布的命名点坐标,不看推理轨迹,也不看最终答案。
三个指标必须分清:
- SR = 95.94%:predicate-level,所有谓词里有多少比例通过;
- SC = 84.0%:strict problem-level,一道题的全部谓词都通过才算成功;
- CR = 100%:非空画布率——只要求画出了东西。
SR 高不代表很多题"完整构造正确"。 举个极端例子:100 道题,每题 10 个谓词,每题都恰好错 1 个——SR 是 90%,SC 是 0%。
CR = 100% 更容易被误读。 它只说明模型"成功产生了非空画布",不说明这些画布符合题意。只要画了对象,哪怕关键约束全漏了,CR 依然是 100%。
再看一组更说明问题的数字。按 SC 是否通过把画布分成两组,比较后续读数质量:
| 读数匹配阈值 | SC 通过(n=215) | SC 不通过(n=41) |
|---|---|---|
| 全部 Ti 严格匹配 | 31.2% | 0.0% |
| ≥90% Ti 匹配 | 83.7% | 7.3% |
| ≥80% Ti 匹配 | 94.4% | 22.0% |
注意怎么读这张表:它支持"构造通过与读数质量相关",而且顺手证明了一件事——SC 通过也不是充分条件,因为严格全部匹配也只有 31.2%。
论文还做了容差扫描,把两类错误彻底分开:结构性目标在五个数量级上稳定停在约 88% 的平台(放宽容差没用),而数值型目标从 1e−4 下的 51% 爬升到 3e−2 下的 94%。这正是第 06 节那个区分的实验证据。
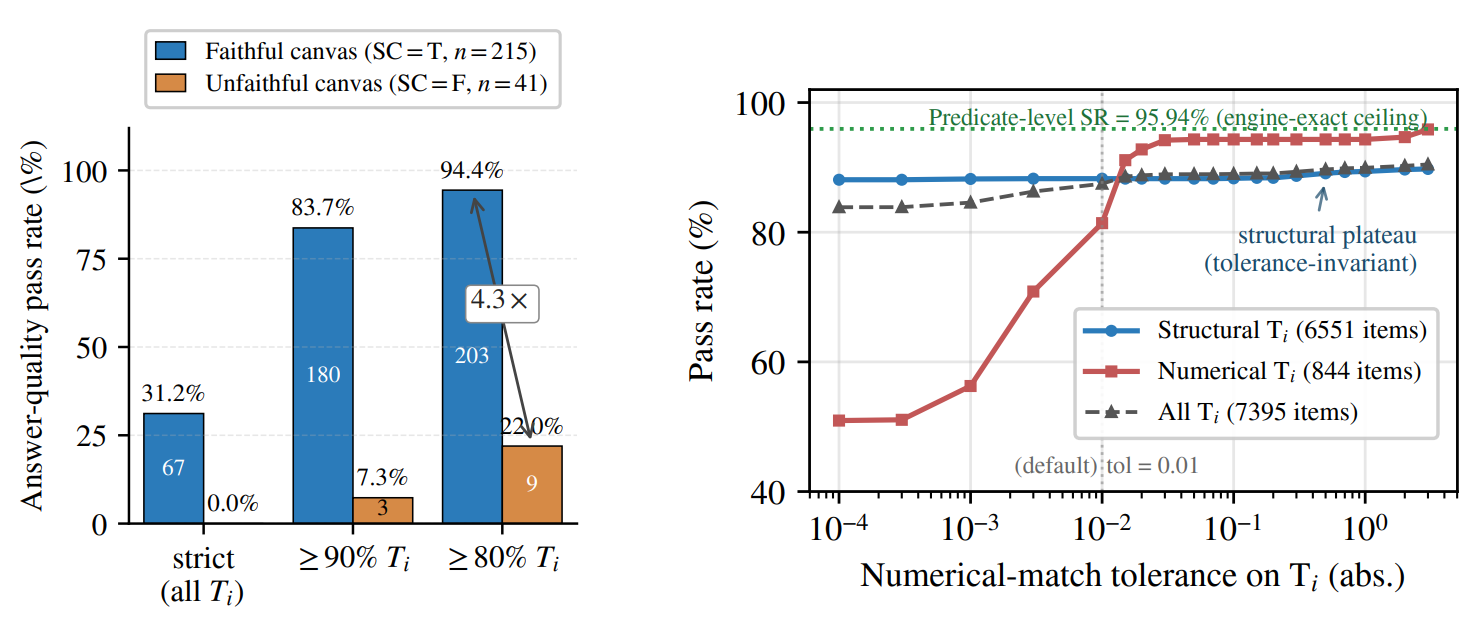
左:搭对的画布读数质量明显更好。右:结构错误放宽容差也不会变好,数值误差放宽容差会变好——两类失败的修法完全不同。
09 论文真正证明了什么,没有证明什么
论文最有价值的贡献之一,是它把三种"正确"分开了。这三层不能合并:
| 层次 | 回答的问题 | 论文实际证据 |
|---|---|---|
| 运行与读数 | 工具按当前输入运行、返回了当前画布的量吗? | typed 接口、引擎返回、错误日志;仍存在数值工具与静默未定义的退化对象 |
| 构造 fidelity | 当前画布满足题目规定的关系了吗? | GeoGoal 指定谓词的容差检查;依赖给定构造文本与有限谓词集 |
| 数学证明 | 对所有满足前提的构型,结论都成立吗? | 本文明确限于数值实例;依赖 DAG 是 proof-relevant 轨迹,不是普遍证明 |
所以论文提供的是 instance-level verification(实例级验证),不是 universally quantified proof(全称量化的证明)。
一个很干净的边界表达:
某个实例上测得 AB ⊥ CD,只说明"对这个已经提交的具体画布状态成立",推不出"所有合法构型都成立"。
还有一个必须提的短语:"engine-exact" 不能无限扩张。论文的实际审计是浮点坐标 + 容差检查(绝对容差 4×10⁻⁷ 或相对 0.1%),工具目录里也包含数值求解。它可以读作"相对于给定状态的受控执行与可检查读数",不能读作"所有返回值都是数学上无误差的符号证书"。
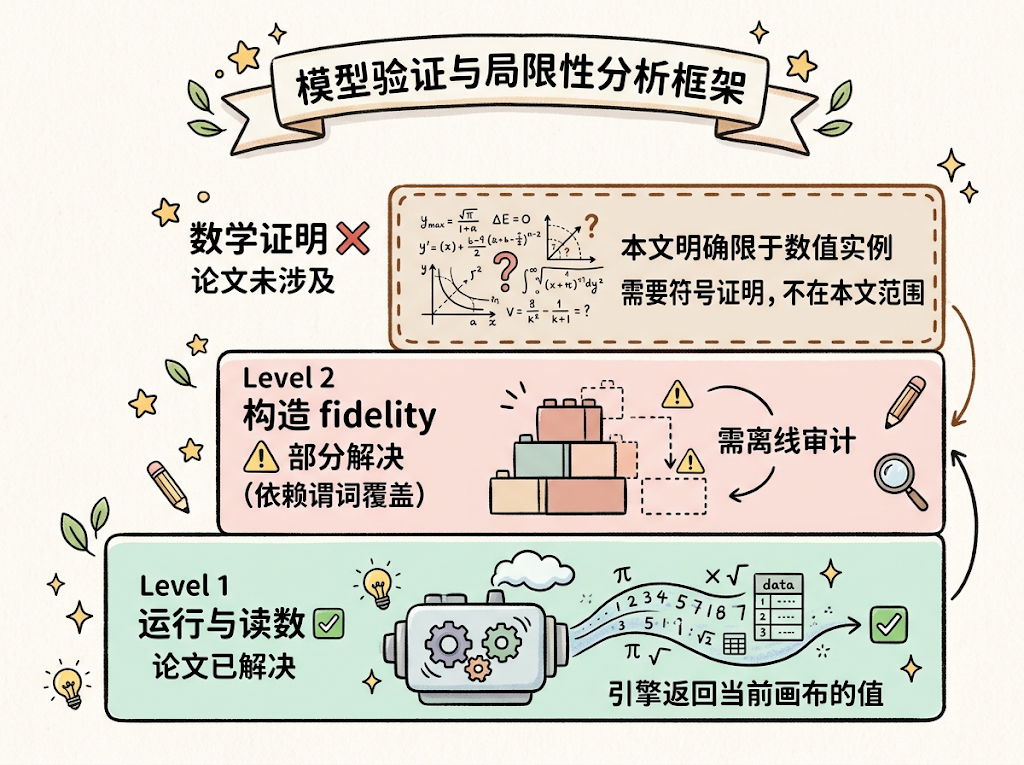
三层"正确",需要三种不同的验证器。一个绿色的成功标记替代不了它们。
| Step | Tool Call | Deps | Used by | Geometric Interpretation | Semantic |
|---|---|---|---|---|---|
| 1 | add_point(A, 0, 0) | ∅ | Point existence | ||
| 2 | add_point(B, 4, 0) | ∅ | Point existence | ||
| 3 | add_segment(AB, A, B) | Two points segment | |||
| 4 | add_perp_line(L, A, AB) | Perpendicular through a point | |||
| 5 | add_circle(c, A, 3) | Center + radius circle | |||
| 6 | add_intersect(P, L, c, 1) | Line–circle intersection (1st) | |||
| 7 | query_distance(B, P) | — | Measurement readout |
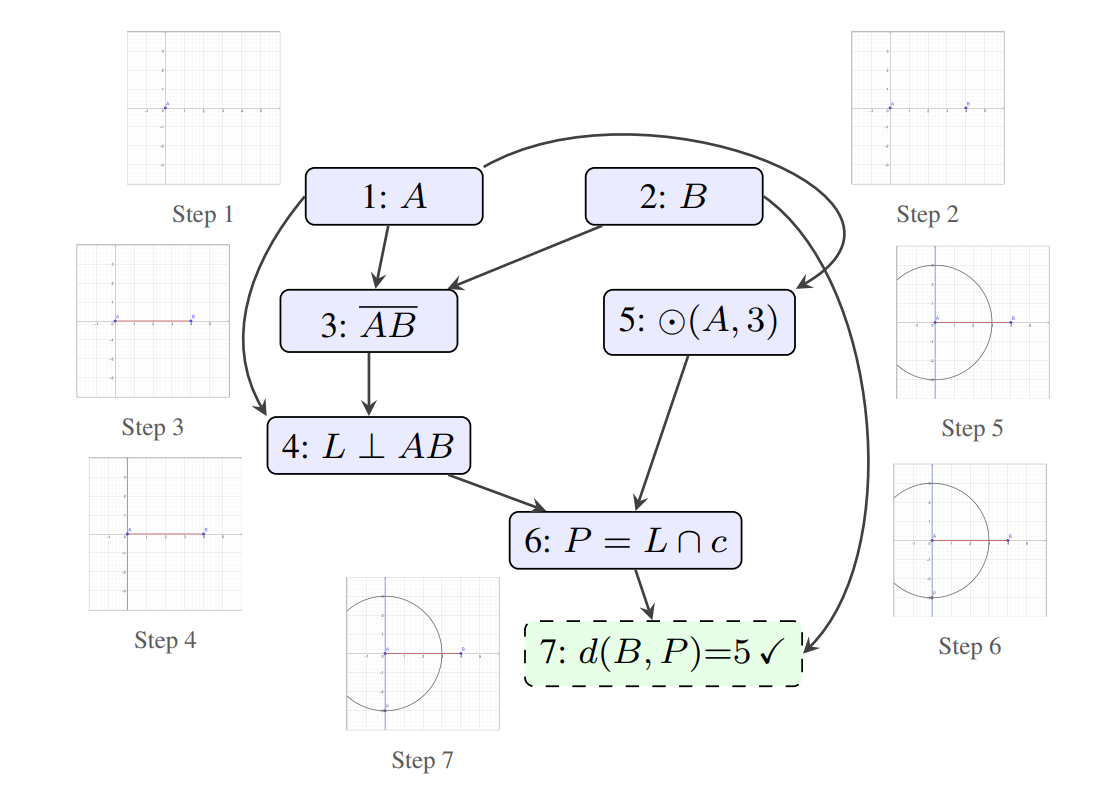
一张图看懂"依赖"是什么意思:删掉任何一个节点,它下游的所有对象一起失效。
10 局限、失败场景,以及如果要复现
作者自己承认的局限,写得挺诚实:
- 单步有效不保证轨迹策略有效:长构造链、歧义感知、遗漏关系仍然失败;
- 某些题根本不需要调用引擎:强制构造只增加开销,需要把"何时调用"交给策略层决定;
- 只面向单个数值欧氏实例:不覆盖一般性量词证明;
- 观察通道偏窄:主要返回对象、变化量和数值,难以发现布局或区域选取错误;
- 跨模型验证规模有限:只在 OlympiadBench 112 题上观察迁移。
公开的失败案例里,有两个特别值得看:
- 执行全对,题意全错:某题 7 轮里前 3 次调用失败被拒绝,之后全部无错,但最终合法画布仍然漏掉 57% 的 GT 谓词。这说明残余负担在 policy-level(策略层),不在执行层;
- 查询错位:模型查了一个无关量,最后绕一圈算出答案,看起来"用了引擎",但答案并非由读数直接介导。
论文还记录了一个细节:失败调用主要来自模型层(引用不存在的对象、在不满足前提时求交、传入退化对象、参数类型错误),另有约 5% 的失败调用涉及退化输入,可能静默产生未定义对象。
如果要复现,需要知道三件事:
- 三条不同的评估管线,别混:普通解题(答案正确率)、GeoGoal(构造 fidelity,模型只交画布、不输出答案)、GenExam(输出图片,多一层渲染工具);
- 数据没有被用来训练。这是 inference-time evaluation:已有基准 → 冻结 VLM → GeoGebra 交互 → 答案/画布/图片 → 评估;
- training-free ≠ 没有工程投入。工具表由 LLM 辅助起草、结合试运行失败整理了约八轮,模型看到的说明包含用途、参数类型、前置条件、命名与角度方向规则。
精读时发现的小瑕疵(写出来是为了让你知道复现时要小心):论文中 MathVista 的正确题数在不同表里出现 203/208 与 204/208 两种口径;绘图失败归因表的分类计数(17+14+4+5=40)未覆盖标题中的 48 个失败。这些不影响主要结论,但精确复现时需要统一逐题日志。
11 对普通开发者、研究者和面试者的启发
对做 Agent 的人:这篇论文最可迁移的经验不是"接一个工具",而是——
把中间工作区设计成可执行对象,而不是只保存一段解释。
它的价值取决于两件事:工作区是否检查了真正重要的约束,以及检查结果是否及时进入决策。
对做评测的人:三个可以直接借用的做法。
- 答案正确率会把"真推对了""靠文字 shortcut""偶然答对"混在一起——所以需要过程指标;
- 消融要按功能通道设计。论文里"无查询"组仍然能通过
add_*的返回值拿到同样数值——函数名删掉不等于信息删掉; - 净收益要同时数 Save 和 Break。八个平面设置合计 N=3796,Save=133、Break=128,净增只有 5 题(约 +0.132 个百分点)。只展示"救回来的案例"会隐藏"原本答对被工具破坏"的题。
对面试者:如果被问到"工具调用 / Agent 的记忆与反馈",这篇论文给了一个很好的答题骨架:
第一,把高不确定性的"提出下一步"留给模型,把确定性的"执行与验证"交给引擎; 第二,要区分"动作被执行了"和"动作是不是题目需要的"; 第三,要区分实例级验证和形式化证明,别把工具的成功标记说成数学证明。
对研究者:这篇论文留下的最大缺口是一句话——
step-level verification ≠ strategy-level reasoning。
GeoGebra 只会告诉你"这条垂线我画成功了",它不会告诉你"你根本不需要画这条垂线"。
论文自己也承认:当前画布主要以平坦 JSON 的形式暴露给模型,DAG 拓扑还没有作为完整规划输入,这是它写进 future work 的。
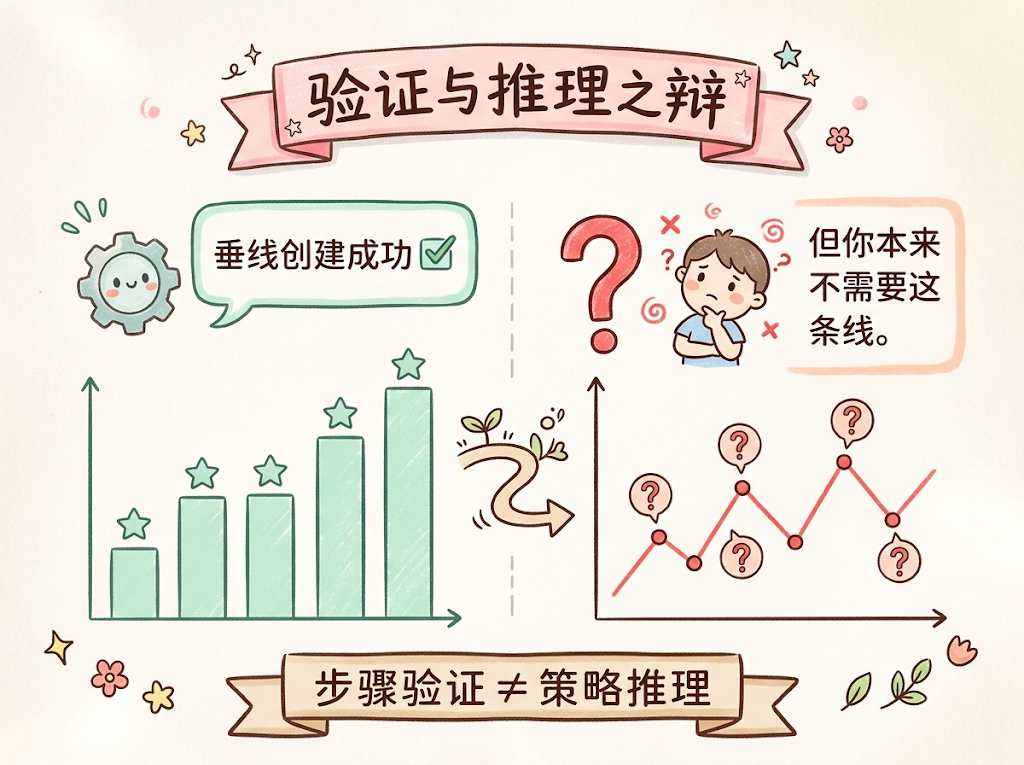
论文解决了"这一步执行对不对",没有解决"这一步该不该做"。这也是下一步研究真正的入口。
12 总结
- Draw2Think 的核心不是"让 VLM 会画几何图",而是把几何推理中的中间状态,变成一个可执行、可测量、可修订的约束工作区;
- 它解决的是 step-level grounding:动作是否被执行、当前画布的真实值是多少;
- 它没有解决 strategy-level reasoning,也没有解决 formal proof:题意理解、整条策略是否合理、结论是否普遍成立,仍然是独立问题。
最该带走的一句话,还是开头那个例子:
引擎可以非常准确地测量一张搭错了的图。它的保证止于画布,不跨到题意。
参考资料
- Draw2Think: Harnessing Geometry Reasoning through Constraint Engine Interaction — https://arxiv.org/abs/2605.20743
- 项目页:https://draw2think.github.io/
- 代码仓库 harness-geometry:https://github.com/draw2think/harness-geometry
- Newclid(符号求解器,本文用其
check_numerical()做谓词检查):https://arxiv.org/abs/2411.11938 - GeoGebra
Prove命令文档(区分当前坐标判断与一般性符号判断):https://geogebra.github.io/docs/manual/en/commands/Prove/ - GeoGebra
NSolve命令文档(数值求解):https://geogebra.github.io/docs/manual/en/commands/NSolve/ - MathCanvas:https://arxiv.org/abs/2510.14958
Copyright Ownership: Kstheme, Contributors: Kstheme
版权所有
版权归属:
许可证: